10 月 16 日晚,英伟达 RTX Spark 笔记本在国内开卖,128GB 统一内存的华硕 ProArt 创16 首发价 37999 元,很快就卖完了,只能先预约。一台笔记本卖近 4 万还被抢光,买家图的都是一件事:把大模型装进自己的机器里跑。但我想先泼点冷水:本地跑大模型,最贵的配置不一定最适合你,买错了可能白花好几万。这篇把选硬件的逻辑一次讲清楚,看完你就能自己算出该买哪一档。
一、先弄懂一件事:想跑得快,模型最好整个放进 GPU 能用的内存
先交代一个前提。本文说的「能不能跑」「跑多快」,默认的都是最常见的本地用法:一个人用,一次只生成一条回复(batch size 1),模型全部放在 GPU 上(llama.cpp 里叫把全部层卸载到 GPU,参数是 -ngl all)。在这个前提下,权重最好整个放进显存,或者统一内存里 GPU 能用的那部分。
放不下也不是完全跑不了。llama.cpp 支持 CPU 与 GPU 混合推理:可以只把一部分层放到 GPU(--n-gpu-layers),剩下的层留在 CPU 上算;MoE 模型也可按后端支持把专家留在 CPU 内存中。这样能运行超过显存容量的模型,但速度还受 CPU 算力、系统内存带宽、设备间传输和具体实现影响。统一内存让 CPU 和 GPU 共享物理内存,减少了独立显存与系统内存之间的数据搬运;它仍有分配限制和带宽竞争,不能据此保证同样的推理速度。
所以第一步是算模型有多大。公式很简单:
模型体积 ≈ 参数量 × 每个参数占的位数 ÷ 8
这里的”位数”就是量化精度。按 llama.cpp 常用的 GGUF 格式实际占用:
- FP16(不量化):16 bit,约等于 参数量(B) × 2 GB
- Q8_0:约 8.5 bit,约等于 参数量 × 1.06 GB
- Q4_K_M(最常用):llama.cpp 量化说明里 Llama 3.1 8B 的实测值是 4.8944 bit/权重,约等于 参数量 × 0.6 GB(换到别的模型会略有不同)
记住最后一条就够用了:4bit 量化下,每 10 亿参数大约占 0.6GB。 按这个系数我算了一下:32B 模型约 19GB,70B 约 42GB,120B 约 72GB。这是估算,实际文件大小以下载页为准。
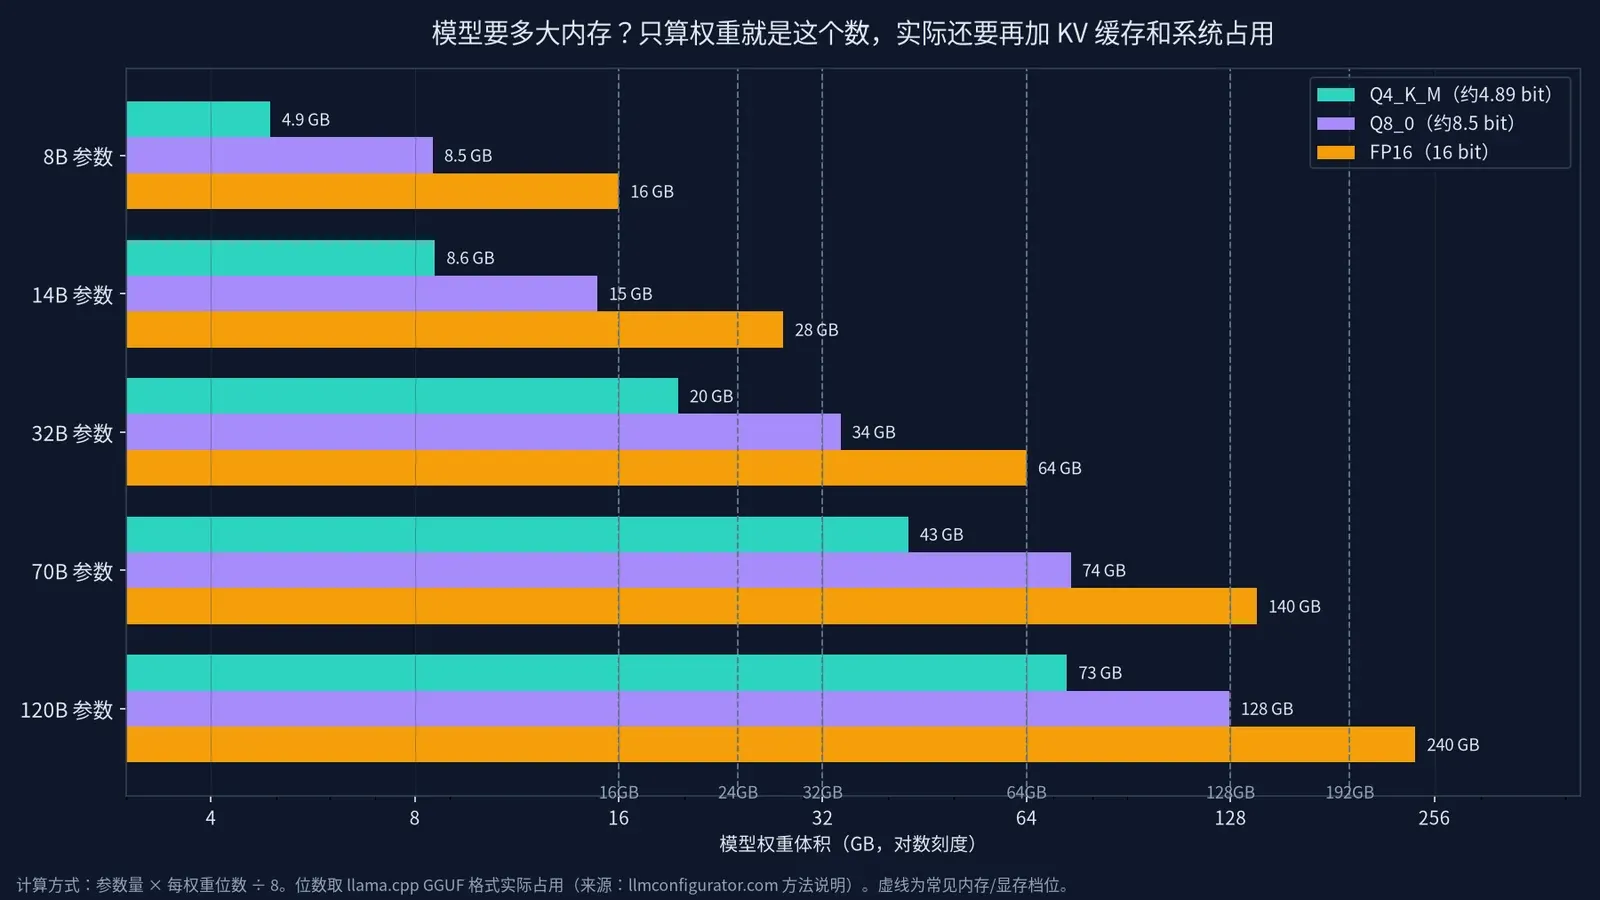
图 1:不同参数量的模型在 FP16、Q8_0、Q4_K_M 三种量化下的权重体积。数值由作者按「参数量 × 每权重位数 ÷ 8」计算,只算权重,不含 KV 缓存和系统占用。来源:每权重位数(F16 16 / Q8_0 8.50 bit)取自llmconfigurator 方法说明;Q4_K_M 用 llama.cpp 量化说明里 Llama 3.1 8B 的实测值 4.8944 bit,换到别的模型会略有不同。作者于 2026 年 10 月 20 日查阅。
但这只是权重。实际还要加两块。
第一块是 KV 缓存,上下文越长,占得越多。以 Llama 3.1 8B 为例,Meta 官方仓库给出的结构是 32 层、32 个注意力头、8 个 KV 头、隐藏维度 4096,所以每个头的维度是 4096 ÷ 32 = 128。KV 缓存的公式是:
KV 缓存字节数 = 2 × 层数 × KV 头数 × 头维度 × 上下文长度 × 每个数的字节数
当 K 和 V 都用 FP16 或 BF16 保存时,每个数占 2 字节。按 8K(8192)上下文算:2 × 32 × 8 × 128 × 8192 × 2 = 1,073,741,824 字节,约 1.07GB(正好 1GiB)。如果把 KV 缓存改成 Q8_0(每个数约 8.5 bit),约 0.57GB。这几个数都是我按公式算的。这只是一路对话的缓存本体,不含分配器和运行时开销。权重量化成 Q4,不代表 KV 也用 4 bit;并发增加时通常还要为各路上下文预留缓存,支持前缀共享的引擎可以复用相同前缀。作为对照,llama.cpp 量化说明里这个模型的 Q4_K_M 权重是 4.58GiB(约 4.9GB)。
第二块是运行框架和其他软件。 推理框架需要工作区、计算缓冲区等额外空间,不能给所有模型套同一个固定预留值。统一内存是 CPU 和 GPU 共用的,浏览器、IDE 也会占用。
所以要分清三个数:
- 总内存:机器上标的那个数,比如 128GB。
- GPU 的分配规则与当前可用内存:它们取决于平台、驱动和系统占用。AMD 官方说明 128GB 的锐龙 AI Max+ 395 最多可设 96GB 图形内存;锐龙 AI Max+ PRO 495 平台最多支持 160GB 专用图形内存,还需核对具体整机与驱动配置。DGX Spark 则是 CPU 与 GPU 共享 128GB 系统内存,不宜把某次工具读数当成所有机器固定的 GPU 上限。这些数字都不等于能全部用于权重。
- 能放权重的空间:在具体平台的分配规则下,结合当前空闲内存,为 KV 缓存、框架和其他软件预留空间;这些占用之间可能共享预算,不能把不同口径的数字机械相减。
Mac 的情况也要按机型和运行环境看。Metal 提供「建议最大工作集」(recommendedMaxWorkingSetSize)作为内存管理参考;苹果关于 M1 Pro/Max 的技术讲座给过对应机型的例子。这是建议值,不能把旧机型的比例直接当成所有新 Mac 的硬性上限。选购时查看目标机型和推理工具报告的可用空间,并为系统留出余量。
RTX Spark 也是这样。英伟达的移植指南说,它把物理内存分成三块:GPU 专用的一块(carveout,Windows 显示为专用显存)、CPU 和 GPU 共享的系统内存、只给 CPU 用的内存。只给 CPU 的那块不能分给 GPU。
英伟达的本地推理配方页给的是一条条具体配方,每条标了「峰值 GPU 内存」(Peak GPU Memory)。几个例子(都在 2026 年 10 月 14 日测过,单路并发):
- Qwen3.8 Flash Next,IQ4_XS 量化,带视觉和 MTP 投机解码,上下文 262144:峰值 78GB。这是页面在 128GB 配置下默认展示的推荐配方。
- Qwen3.8-27B,Q4_K_M 量化,上下文 262144:36GB。
- Qwen3.6-35B-A3B,IQ4_XS 量化,上下文 101376:24GB。
这些是单条配方的实测峰值,换个上下文长度或并发数就会变,不是哪档内存机器能跑的模型上限,也不能拿它和总内存的比例去套别的配置。不同平台的分配规则差别很大,买前要查清楚。
MoE 模型是个例外,也是好消息
现在很多开源模型是 MoE(混合专家)结构,比如 Qwen3.6-35B-A3B:总共 35B 参数,每次只激活约 3B。
常规部署按总权重估算容量,激活参数只帮助理解每一步的计算量,不能直接换算速度。 Qwen 官方模型卡给出的 35B 总参数、约 3B 激活参数不代表它必然跑得和 3B 稠密模型一样快。实际速度还受注意力结构、共享层、专家路由、量化内核和内存访问影响。把部分专家留在 CPU 上可以降低 GPU 容量要求,但要实测相应的性能代价。大内存统一内存设备的价值首先是能容纳更多权重,生成速度仍需按具体模型判断。
二、第二个数字:内存带宽决定速度
装得下之后,问题就变成跑多快。
先限定为单用户、batch size 1、权重全在 GPU 上,并采用常规逐 token 解码。在主要受内存读取限制的情况下,可以用每步需要读取的权重和缓存数据估算生成速度。常规稠密 Transformer 会访问大量权重和已有 KV;MoE、滑动窗口和混合注意力模型的访问量不同,不能一律当成完整模型和全部缓存各读一遍。一个简化的带宽估算是:
每秒 token 数 ≈ 内存带宽 ÷ 每个 token 要读的数据量(激活的权重 + KV 缓存)
拿 32B 稠密模型做一个只计权重读取的理想估算。Q4_K_M 按 4.8944 bit 算,权重约 32 × 4.8944 ÷ 8 ≈ 19.6GB。为了简单,这里没算 KV 缓存。下面几个数都是我按公式算的:
- 273GB/s(DGX Spark):约 14 token/s
- 614GB/s(M5 Max 40 核):约 31 token/s
- 1344GB/s(RTX 5090 D v2):约 69 token/s
实际软件跑不满理论带宽。按 llmconfigurator 拿公开测试数据拟合的结果,真实利用率大约在 45% 到 85% 之间。这个比例来自该工具的拟合,不能保证适用于所有硬件和软件;上面的数是简化估算,不是实测或通用速度上限。
这个公式什么时候不准
- 上下文很长:常规全注意力模型通常需要读取更多历史 KV,生成速度可能下降;具体幅度取决于模型的注意力结构、缓存精度和实现。
- 部分权重在 CPU 上:留在 CPU 的那部分要按系统内存带宽算,它往往会成为最慢的一环。
- 多个请求一起跑(batching):多个请求可以分摊权重读取成本,提高总吞吐,但单路延迟是否改善取决于批量和调度。不同上下文通常分别占用 KV 缓存;支持前缀共享的引擎可以复用相同前缀。团队共用机器时,应分别测总吞吐和单路响应速度。
- 提示词缓存与推测解码:提示词缓存主要节省相同前缀的输入处理时间,不能直接当成解码提速倍数。推测解码、MTP 等可能一次验证并接受多个 token,也会改变这里的逐 token 估算。输入处理和生成阶段应分开测试。NVIDIA 的推理优化说明介绍了这些区别。
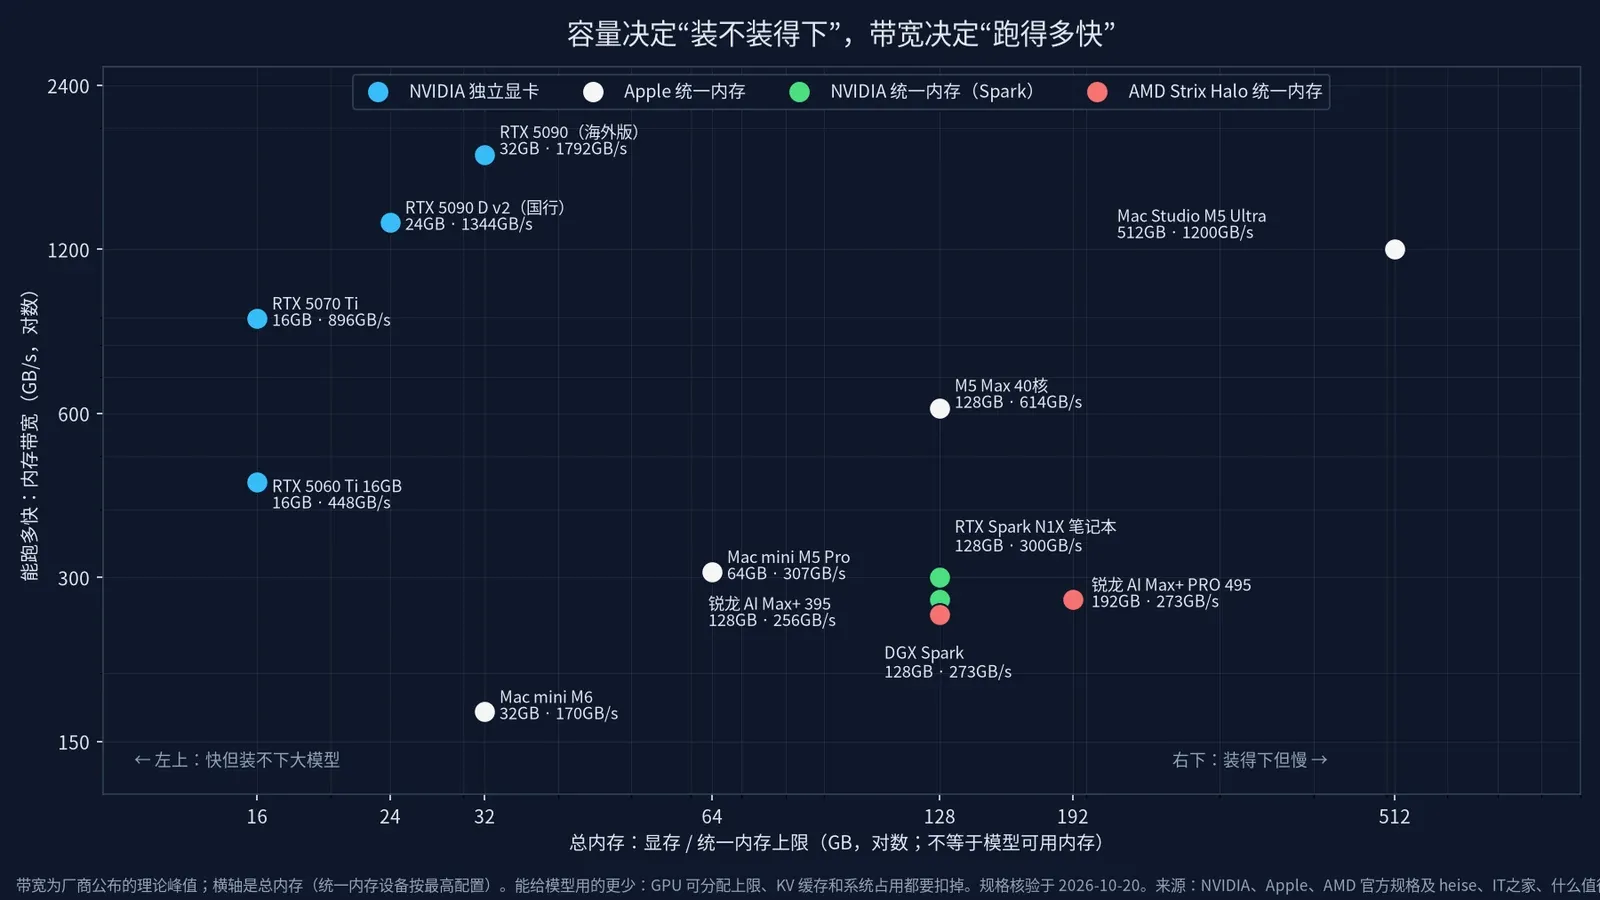
图 2:主流本地推理设备的总内存与内存带宽。横轴是总内存(统一内存设备按最高配置),不是模型可用内存;带宽是厂商公布的理论峰值,不是实测。来源:NVIDIA RTX Spark 规格、Notebookcheck、ReadyGPU(DGX Spark)、Apple Mac Studio 规格、Apple Mac mini 规格、AI Indigo(锐龙 AI Max+ 395)、什么值得买(495)、heise、IT之家(5090 D v2)、pcbench(5060 Ti),作者于 2026 年 10 月 20 日核验。
这张图是全文最值得收藏的一张。横轴是总内存,帮助判断容量档位;纵轴是理论内存带宽,是影响速度的因素之一,不是实测生成速度:
- 左上角是独立显卡:带宽极高,但显存只有 16 到 32GB。
- 右下角是 128GB 级统一内存机器(RTX Spark、DGX Spark、AMD Strix Halo):装得下大模型,但带宽只有 256 到 300GB/s。
- Apple 的 Max 和 Ultra 在中间偏右上:容量和带宽都不错,代价是价格。
实测也印证了这个规律。StorageReview 测 Surface Laptop Ultra(RTX Spark)时,Llama 3.1 8B 跑 56.4 token/s,同组 RTX 5090 笔记本显卡(24GB)跑 128.8 token/s,快 2.3 倍。但到了长上下文的智能体测试,用的是 gpt-oss:20b 和 Qwen3.6-35B-A3B(后者约 21.1GB),这台 Surface 能跑 58 到 89 token/s。这组测试要求约 40GB 以上的 GPU 可用内存,那台 5090 笔记本只有 24GB 显存,没达到门槛,没有跑。
选择时先确认权重、缓存和运行开销能否放下,再比较同一模型和设置下的实测速度。高带宽独显通常适合容量以内的任务,大容量统一内存设备则提供另一种容量与性能取舍。
三、2026 年 10 月主流选择一览
| 设备 | 总内存 | GPU 可分配上限或配方示例(有来源的数字) | 带宽(理论) | 国内参考报价 |
|---|---|---|---|---|
| RTX 5060 Ti 16GB | 16GB 显存 | 16GB 显存独享,不与系统共用 | 448GB/s | 显卡 6799 元(京东自营促销价,10 月 17 日) |
| RTX 5090 D v2(国行) | 24GB 显存 | 24GB 显存独享,不与系统共用 | 1344GB/s | 官方 16499 元起;10 月 16 日行情约 29999 元 |
| Mac mini M5 Pro | 最高 64GB 统一内存 | 未查到官方数字(见上文 macOS 说明) | 307GB/s | 12999 元起;64GB/1TB 约 22749 元(ZOL) |
| 锐龙 AI Max+ 395 迷你主机 | 128GB 统一内存 | 核显最多分 96GB | 256GB/s | 128GB 款约 13649 至 15799 元(ZOL) |
| RTX Spark 笔记本 | 32 至 128GB 统一内存 | 未查到官方总上限;配方示例:128GB 档推荐配方峰值 78GB(Qwen3.8 Flash Next IQ4_XS,262K 上下文) | 300GB/s | 18999 元起;128GB 35999 元起 |
| DGX Spark | 128GB 统一内存 | CPU/GPU 共享,实际可分配空间依系统与运行环境 | 273GB/s | 美国官网 6950 美元(按 10 月 20 日中间价折合约 46704 元,作者换算);ZOL 国内参考价 37929 元 |
| Mac Studio M5 Max | 最高 128GB 统一内存 | 未查到官方数字(见上文 macOS 说明) | 460 / 614GB/s | 19999 元起;128GB 39499 元(ZOL) |
| 锐龙 AI Max+ PRO 495 迷你主机 | 192GB 统一内存 | 专用显存最多 160GB(AMD 官方) | 约 273GB/s(256-bit LPDDR5x-8533,作者换算) | 45999 至 51999 元 |
| Mac Studio M5 Ultra | 96 至 512GB 统一内存 | 未查到官方数字(见上文 macOS 说明) | 1.2TB/s | 46999 元起 |
表:2026 年 10 月主流的本地推理设备。第三列只填有来源的数字:独立显卡列的是物理显存,仍需为缓存和运行开销留余量;AMD 的图形内存上限依平台及具体配置,不等于能放权重的空间;DGX Spark 的 CPU 与 GPU 共享系统内存;RTX Spark 只列英伟达单条配方的实测峰值 GPU 内存(2026 年 10 月 14 日测),不是机器上限;查不到的写「未查到官方数字」。带宽是厂商公布的理论值,495 的带宽由作者按 256-bit × 8533MT/s 换算。国内参考报价(标价、首发价或 ZOL 参考价,不是成交价)由作者在 2026 年 10 月 16 日至 19 日采集,规格和官网价于 10 月 20 日核验;DGX Spark 的人民币金额是作者按 2026 年 10 月 20 日中间价 6.7200 换算的。各项出处见文末参考资料。
表里的价格都是参考报价,也就是商品页的标价、首发价或 ZOL 参考价,不是实际成交价。国内价格采集于 2026 年 10 月 16 日至 19 日,规格和官网价核验于 10 月 20 日。DGX Spark 的人民币金额是作者按 2026 年 10 月 20 日美元兑人民币中间价 6.7200 换算的(6950 × 6.72),不含关税、增值税和运费,不等于国内实际售价。
几个要点:
RTX Spark 是这次的新物种:英伟达 Blackwell GPU 加 Grace CPU 做在一颗芯片上,最高 128GB 统一内存,跑 Windows,支持 CUDA。优点是 CUDA 生态和便携。注意 N1X 有两个版本:20 核 CPU 加 6144 核 GPU 的满血版最高 128GB,18 核加 5120 核的版本官方规格最高只到 32GB,商品页上一定要看清楚。
DGX Spark 是同一代芯片(GB10)的桌面小主机,跑 Linux。受内存涨价影响,128GB 版在美国从首发约 4000 美元涨到了 6950 美元,英伟达另外推出 64GB 版,起价约 4999 美元,由合作厂商销售。
AMD Strix Halo 是本文列出的 128GB 统一内存机器里最便宜的一档。新的 495 把内存上限提到 192GB(AMD 官方规格:256-bit LPDDR5x-8533,按此换算带宽约 273GB/s),专用显存最多可分 160GB,CPU 和 GPU 基本没变。有实测显示,DeepSeek V4 Flash 在 128GB 的 395 上装不下,换到 192GB 的 495 能跑到约 14 到 15 token/s;Qwen3.6-35B 在 495 上约 90 token/s,395 上约 62。
Mac Studio 是带宽最均衡的选择:M5 Max 40 核 614GB/s,在本文列出的 128GB 级机器里带宽最高;M5 Ultra 到 1.2TB/s、最高 512GB,512GB 版官方说 10 月下旬发售,价格还没公布。
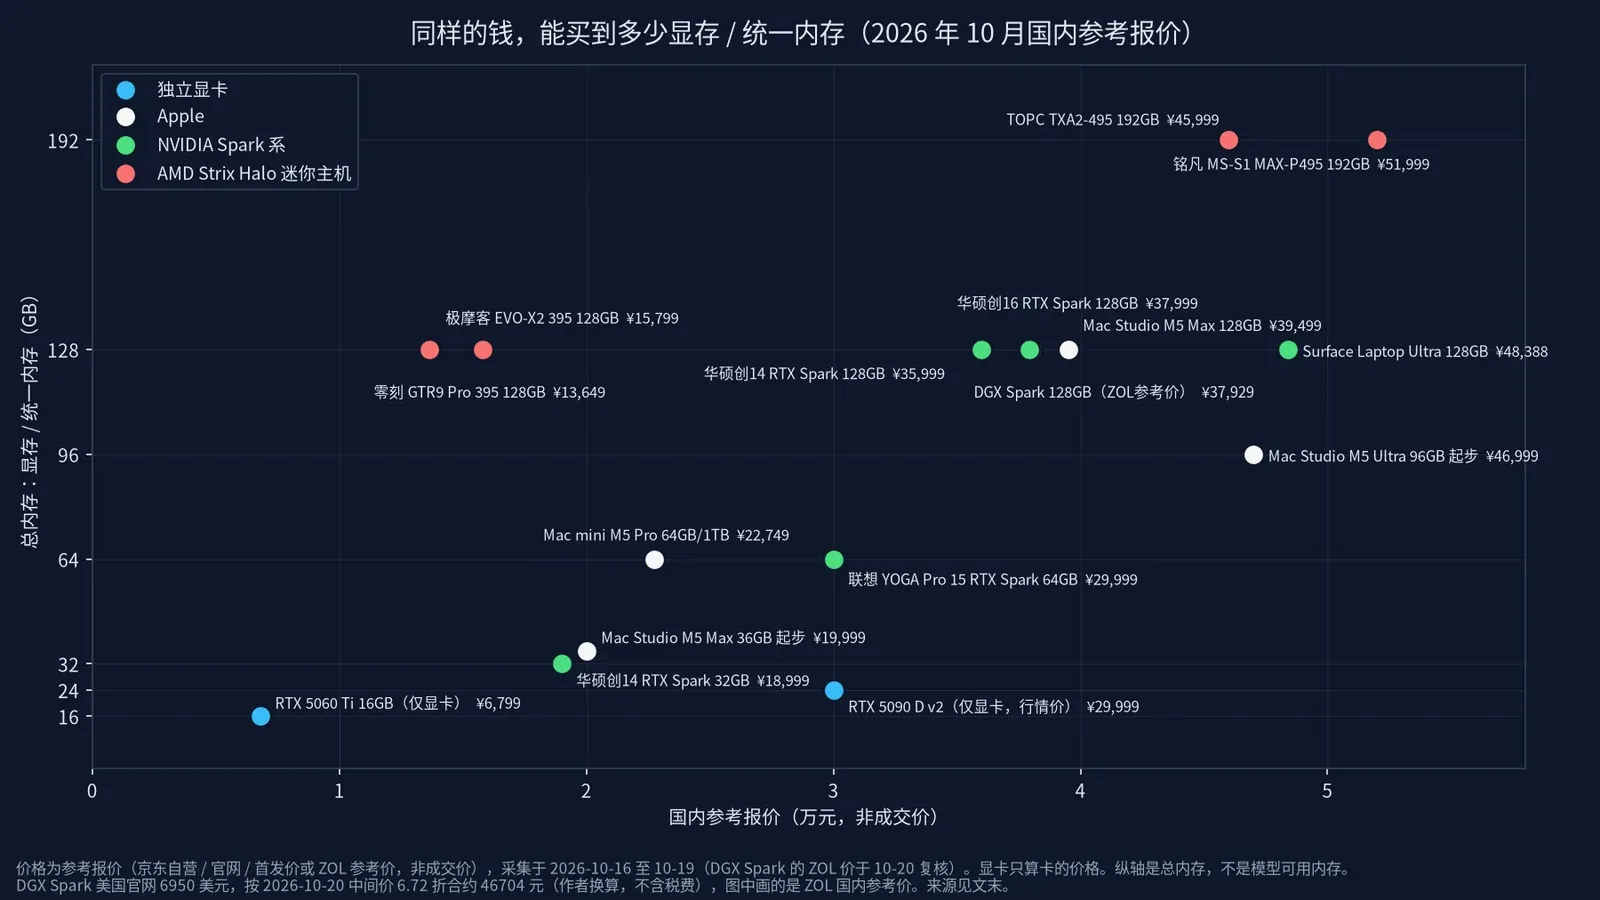
图 3:同样的预算能买到多少显存或统一内存。纵轴是总内存,不是模型可用内存。价格是参考报价(标价、首发价或 ZOL 参考价),不是成交价,由作者在 2026 年 10 月 16 日至 19 日采集,来自京东自营、官网、首发价或 ZOL 参考价;显卡只算显卡本身。DGX Spark 用的是 ZOL 国内参考价(10 月 20 日复核);美国官网价 6950 美元按 2026 年 10 月 20 日中间价 6.7200 折合约 46704 元,是作者换算的,不含税费。来源:什么值得买 RTX Spark 价格汇总、什么值得买显卡行情(10 月 16 日)、什么值得买 RTX 5060 Ti、什么值得买(495)、Apple 新闻稿、ZOL Mac Studio 报价、ZOL Mac mini 报价、NVIDIA Marketplace、中新网汇率中间价。
四、按预算怎么买
1 万元以内:先别急着买。 有电脑的话,先用现有的电脑跑 7B 到 14B 的模型试试(适合显存或内存在 16GB 左右的机器)。想加一张卡,16GB 显存(比如 RTX 5060 Ti 16GB)能比较舒服地跑 14B 级 Q4 模型。显卡今年在涨价,买前多比价。
1.3 万到 2.3 万:性价比最集中的一档。
- 只想要大内存、预算最紧:锐龙 AI Max+ 395 128GB 迷你主机,能装下 70B 级 Q4 和 gpt-oss-120b 这类模型,但带宽只有 256GB/s,大稠密模型会慢。
- 用 Mac、要安静省心:Mac mini M5 Pro 64GB,跑 30B 级 MoE 模型很合适。
2.9 万到 4 万:128GB 主力机。
- 要移动加 CUDA:RTX Spark 128GB 笔记本(35999 元起)。
- 要速度:Mac Studio M5 Max 128GB(39499 元),614GB/s 的带宽在本文列出的同价位设备里最高。
- 要 Linux 加英伟达全套开发栈、做微调:DGX Spark。注意它的价格看渠道:ZOL 国内参考价 37929 元,落在这一档;美国官网 6950 美元,按 10 月 20 日中间价折合约 4.67 万元(作者换算,不含税费),那就属于下一档。
4.5 万以上:团队或合规场景。 数据必须留在本地、要跑 200B 以上的模型,再看 495 的 192GB 机器或 Mac Studio M5 Ultra。
按人群一句话
- 写代码、做 RAG 的独立开发者:64GB 统一内存加 30B 级 MoE 模型,够用很久。
- 做图像和视频生成(ComfyUI 等):优先英伟达,CUDA 生态最成熟。
- 想把 100B 级模型常驻本地:先核对具体量化权重、上下文和并发占用;128GB 是可优先考察的容量档位,不是所有 100B 模型的统一最低要求。
- 只是好奇想试试:先用现有设备,或者租云 GPU,跑清楚自己要用哪个模型再掏钱。
五、五个常见坑
- 只看容量不看带宽。 内存决定装不装得下,不决定跑多快。128GB、256GB/s 的机器跑 70B 稠密模型,单用户、batch 1 时按公式算的理论上限也就 6 token/s 左右。
- 以为内存以后能加。 统一内存基本都是焊死的。硬盘还能后补,内存买多少就是多少,宁可一步到位。
- 忽略系统占用。 统一内存是全机共享的。StorageReview 测试中,RTX Spark 本地跑编程智能体时,浏览器跑分几乎腰斩。边跑模型边干活,要多留余量。
- 忽略软件生态。 RTX Spark 跑的是 Windows on Arm,x64 软件靠转译运行,部分 Arm64 移植版本还不成熟;DGX Spark 是 Linux;Mac 走 Metal 和 MLX。买之前确认你要用的工具都支持。
- 追”千亿参数”宣传。 宣传页上的”本地跑千亿模型”通常只对应顶配。先回答一个问题:你要跑的到底是哪个模型?
六、软件怎么选
- Ollama:一行命令拉模型、开 API,最省事。StorageReview 在 RTX Spark 上就是用 Arm64 原生版的 Ollama 和 llama.cpp 测的。
- LM Studio:图形界面,适合不想敲命令的人,Mac 上可以直接用 MLX 格式的模型。
- llama.cpp:很多工具底层的推理引擎,GGUF 量化格式就出自这里,支持 CUDA、Metal、Vulkan 等后端,想精细调参就用它。
- MLX:Apple 官方开源的机器学习框架,专为 Apple 芯片优化,在 Mac 上跑、训练、微调都可以。
新手建议:用 Ollama 或 LM Studio 起步。和前面的预算建议一致:显存或内存在 16GB 左右的机器,先跑 7B 到 14B 的模型;统一内存 32GB 以上(或显存 24GB)的机器,再试 Q4_K_M 的 30B 级 MoE 模型。这类模型的权重按公式算约 18 到 21GB(StorageReview 用的 Qwen3.6-35B-A3B 是 21.1GB),作为参照,英伟达给 Qwen3.6-35B-A3B(IQ4_XS、约 10 万上下文、单路)的配方峰值是 24GB。32GB 的机器剩下的空间不多,上下文要开短一点;想开长上下文,就要更大的内存。先感受一下速度,再决定要不要升级硬件。
最后
选硬件就三步:先定模型,再算内存,最后看带宽和预算。
今年内存和显卡都在涨价:据 The Register,DGX Spark 比一年前贵了近 75%;RTX 5090 D v2 官方起售价 16499 元,10 月 16 日的行情价约 29999 元。这时候更不该冲动下单。先把你要跑的模型想清楚,这篇里的公式和图够你算明白。
觉得有用就收藏一下,下次买机器前翻出来对一对。
(文中价格都是参考报价,不是成交价。国内价格采集于 2026 年 10 月 16 日至 19 日,来自京东自营、官网首发价和 ZOL 参考价;官方规格、英伟达推荐搭配、DGX Spark 美国官网价和 ZOL 参考价于 10 月 20 日再次核验。汇率用的是 2026 年 10 月 20 日的美元兑人民币中间价 6.7200。促销和涨价随时会变,以下单页面为准。文中写明「我按…算」「作者换算」的数字都是我自己算的。)
参考资料
- NVIDIA 新闻稿:RTX Spark PCs Available Today(2026-10-16)
- NVIDIA RTX Spark 规格页
- Notebookcheck:RTX Spark N1X 规格与跑分
- 什么值得买:RTX Spark 国内价格与 NVIDIA 推荐搭配汇总
- 什么值得买:华硕创16 128GB 京东自营 37999 元
- StorageReview:Surface Laptop Ultra(RTX Spark)评测
- NVIDIA Marketplace:DGX Spark
- The Register:DGX Spark 涨价与 64GB 版(2026-10-02)
- ReadyGPU:DGX Spark 规格
- Apple 新闻稿:Mac Studio M5 Max / M5 Ultra
- Apple:Mac Studio 技术规格
- Apple:Mac mini 技术规格
- Apple 新闻稿:Mac mini M6 / M5 Pro
- ZOL:Mac Studio M5 Max 报价及对比(含 DGX Spark 国内参考价)
- 国家外汇管理局:人民币汇率中间价查询
- 中新网:2026 年 10 月 20 日人民币汇率中间价
- ZOL:Mac mini M5 Pro 报价
- AI Indigo:GMKtec EVO-X2(锐龙 AI Max+ 395)
- 什么值得买:锐龙 AI Max+ PRO 495 迷你主机
- NVIDIA 中国:RTX 5090 D v2
- IT之家:RTX 5090 D v2 评测
- 什么值得买:10 月 16 日显卡行情
- 什么值得买:RTX 5060 Ti 16GB 京东自营价
- llmconfigurator:显存与速度估算方法
- vram-calc:显存估算工具
- NVIDIA Local AI Inference Recipes:RTX Spark(配方页,2026-10-14 实测)
- NVIDIA RTX Spark 移植指南:Unified Memory Architecture
- AMD 锐龙 AI Max+ PRO 495 产品规格
- AMD 博客:Ryzen AI Max PRO 400 系列(含 160GB 显存脚注)
- llama.cpp quantize README(Llama 3.1 8B 各量化 bpw)
- Meta llama-models:sku_list.py(Llama 3.1 8B 结构参数)
- Apple Tech Talk:Metal 与 M1 Pro/Max 内存
- llmconfigurator:调高 Apple Silicon 的 Metal 显存上限
- llama.cpp server README(—n-gpu-layers、—cpu-moe、cache_prompt)
- Anyscale:连续批处理与 LLM 推理
- The LLM Stack:Continuous batching