ChatGPT 的记忆功能会记下用户的信息,下次对话时拿来用。一篇发表在 ACM Web Conference 2026 的论文,用 80 位真实用户捐出的数据,看了它到底记了什么。
结论有三条:绝大多数记忆未检测到用户的明确指令;记忆里常有个人数据和心理状态;多数记忆能在用户消息和已有记忆中找到依据。问题不在单条记忆,而在它们会自动攒成一份关于「你是谁」的档案。
研究怎么做的
论文叫《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》(算法自画像:拆解 ChatGPT 的记忆),作者来自德国马普研究所、波鸿鲁尔大学、荷兰代尔夫特理工大学等机构。
研究者从众包平台 Prolific 招募了 80 位经常用 ChatGPT 的人,大多在美国和欧洲。他们按欧盟 GDPR 的权利导出自己的 ChatGPT 数据,捐给研究者。
ChatGPT 存记忆时会调用一个内部工具,留下「Model set context updated」的记录。研究者据此找出了 2050 条记忆,来自其中 65 人、1058 个对话。
记忆里有没有个人数据、有没有心理状态,由 GPT-4o 按规则标注,再由人工抽查。
四个数字
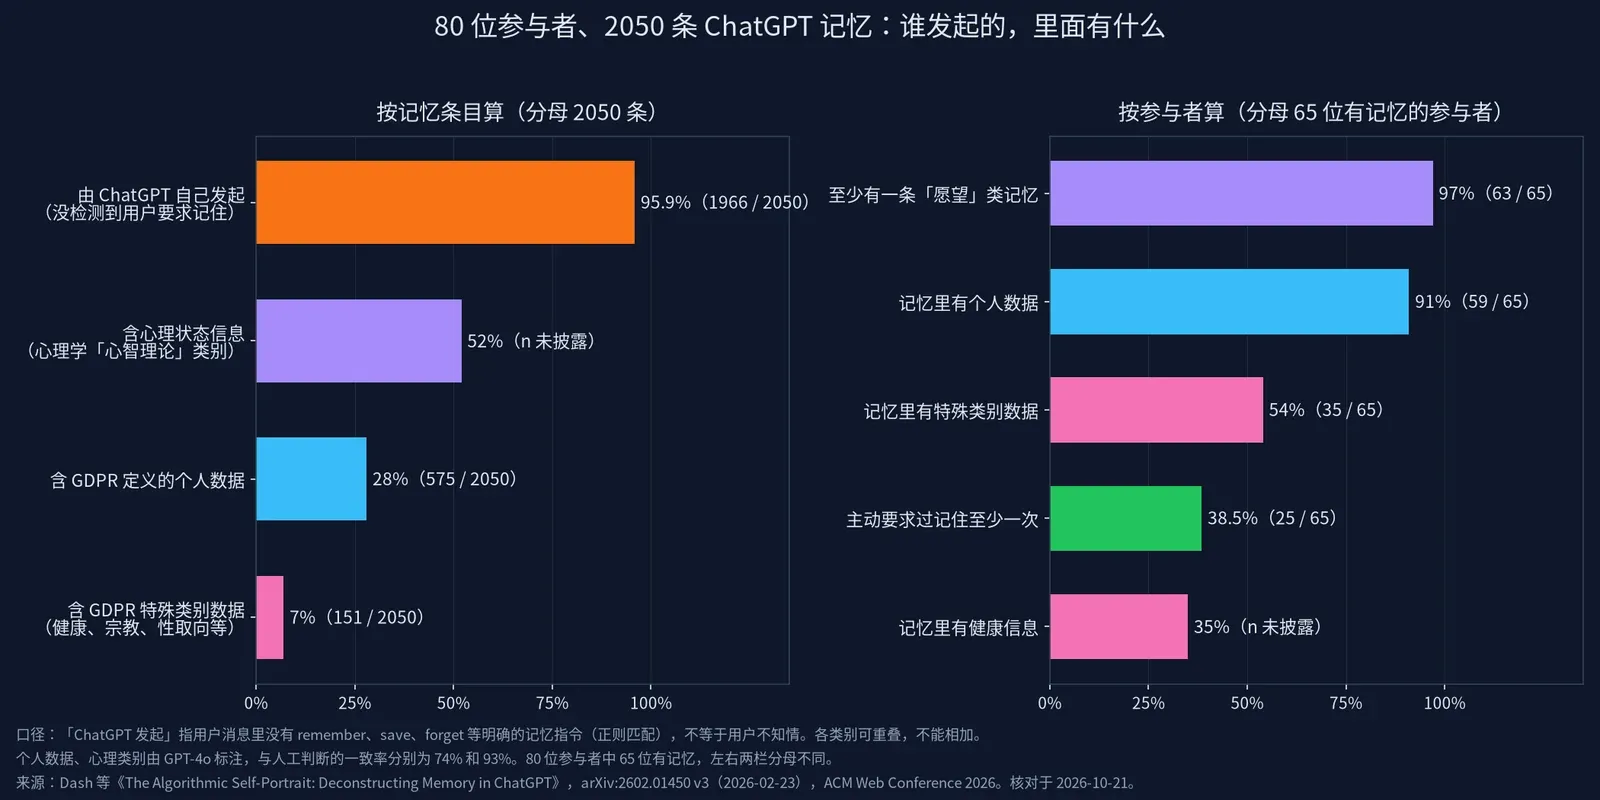
图 1:2050 条 ChatGPT 记忆里有什么。左右两栏分母不同;各类别可以重叠,不能相加。「ChatGPT 发起」指用户消息里没检测到明确的记忆指令,不等于用户不知情。个人数据和心理类别由 GPT-4o 标注,与人工判断的一致率分别为 74% 和 93%。来源:Dash 等《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》,arXiv 第三版(2026 年 2 月 23 日),ACM Web Conference 2026,核对于 2026 年 10 月 21 日。
96% 的记忆没有检测到用户的明确指令。 研究者用关键词匹配记住、保存、忘记等操作请求,2050 条里只匹配到 84 条(4.1%),涉及 65 人中的 25 人。这不代表用户不知情:OpenAI 的说明写明 ChatGPT 可能不经要求就保存信息,App 存记忆时也会弹出提示。
28% 含个人数据。 也就是 GDPR 定义的、能识别到具体个人的信息,最常见的是姓名和经济、社会、文化身份。另有 7% 含健康、宗教、性取向这类「特殊类别」数据,其中健康最多。按人算,91% 的人记忆里有个人数据,35% 有健康信息。这一项标注的可靠性偏低:GPT-4o 和人工判断的一致率只有 74%。
52% 含心理状态。 研究者用心理学「心智理论」的七个类别标注,比如愿望、意图、情绪、信念。在含至少一种心理状态的记忆中,「愿望」最多,占 73%。例子:「用户想专注于改善自我调节能力」(意图)、「用户有时感到孤独,尽管有朋友和家人」(情绪)。
词语与完整上下文的平均重合率为 84%。 这里的上下文包括用户消息和既往记忆,并不只是用户原话;重合也不等于整句话的意思相同。
多数记忆能在上下文中找到依据
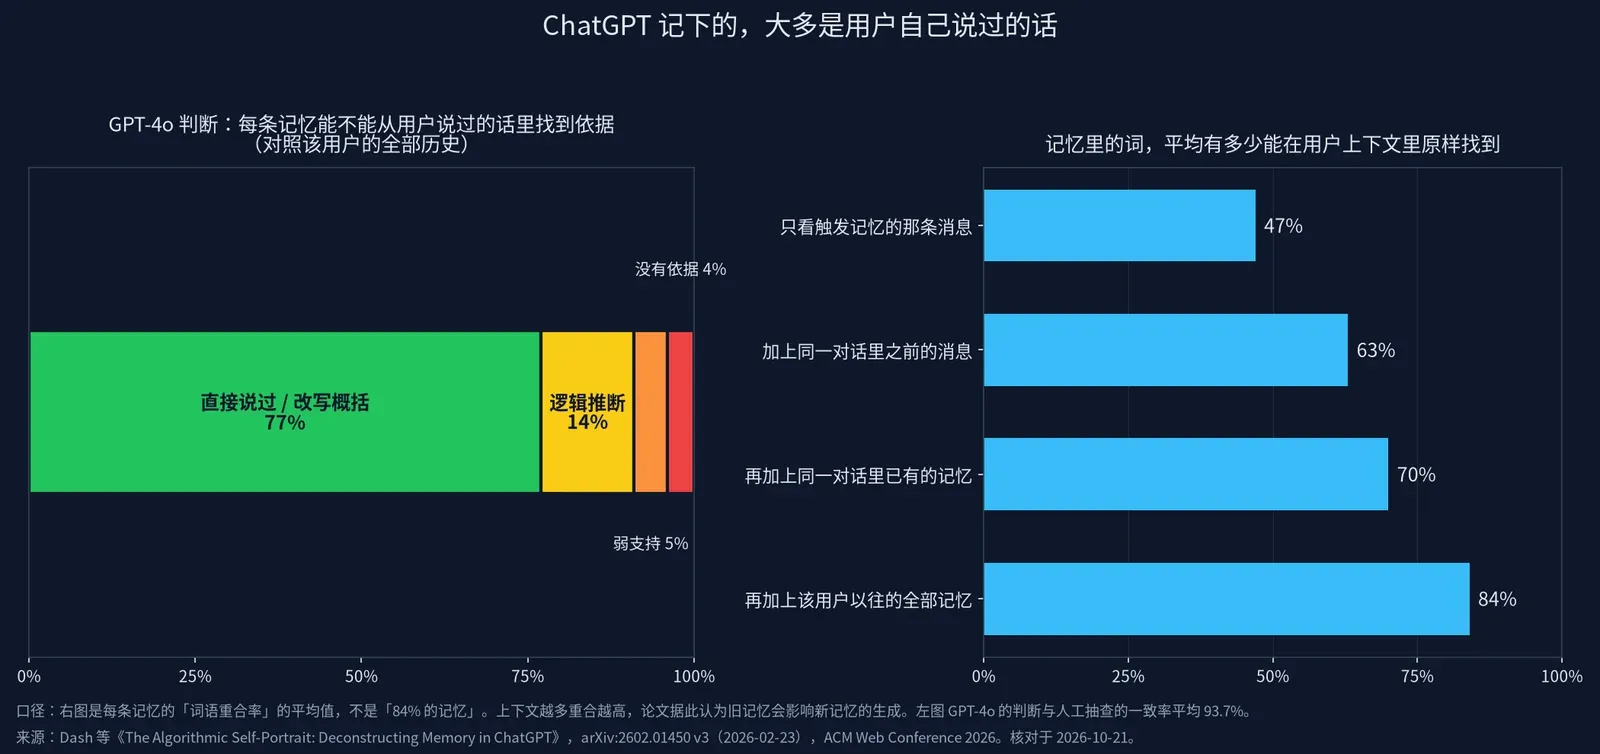
图 2:记忆从哪里来。右图是每条记忆的词语重合率的平均值;完整上下文包括用户消息和既往记忆,不是「84% 的记忆」或「84% 都来自用户原话」;左图是 GPT-4o 对照研究定义的完整上下文(当前对话及已有记忆)的打分,与人工抽查的平均一致率 93.7%。来源:Dash 等《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》,arXiv 第三版(2026 年 2 月 23 日),ACM Web Conference 2026,核对于 2026 年 10 月 21 日。
「心理状态」描述记忆里写了什么,不代表这些内容都是系统推测出来的。
研究者让 GPT-4o 对照当前对话及已有记忆打分:77% 的记忆被判为有直接依据或属于改写概括,14% 是逻辑推断,5% 依据很弱,4% 找不到依据。推断加上没依据的,约占 23%。
例子:用户说「推荐几支像 Nirvana 的乐队」,记忆写成「用户喜欢 Nirvana」,被判为依据很弱。
另一个发现:只看触发记忆的那条消息,记忆里的词平均 47% 能找到;加上同一对话先前的用户消息和该用户的既往记忆,升到 84%。研究者据此认为,旧记忆会影响新记忆的生成。
自动记忆为什么会变成画像
单条记忆看起来都很普通:「在准备面试」「想改善睡眠」「对换工作有焦虑」。但它们会一条条攒起来,而且越攒越影响新的记录。
ChatGPT 更常记下长期特征。在含心理状态的记忆中,愿望占 73%、意图占 16%,情绪和感知分别占 14% 和 7%;一条记忆可属于多个类别,比例不能直接相加。论文认为这符合 OpenAI「记长期有用的信息」的设计。结果是,系统记下的恰好是最能描述「你是什么样的人」的那部分。
多数写入由系统发起。样本中约 96% 的记忆没有检测到用户的明确指令;保存时的提示也不等于逐条征得同意。
敏感信息也没有被完全挡住。论文引用的 OpenAI 说明写着,ChatGPT 被训练成不主动记健康等敏感信息,除非用户要求;但样本里 7% 的记忆含这类数据,涉及过半参与者。OpenAI 现在的说明改成了:「如果你和 ChatGPT 分享了敏感信息,它可能出现在记忆里。」
研究者还用开源模型模拟了每条消息都提取记忆的情况。按研究的个人数据口径,生成记忆中含个人数据的比例约为 31.6%–35%,高于 ChatGPT 样本的 28%。这提示写入门槛会影响画像的细致程度。
这几个数字容易被误读
- 「80 个用户的 2050 条记忆」:2050 条只来自其中 65 人,其余 15 人的捐赠记录中未识别出这类记忆。
- 「96% 是系统生成的」:准确说法是没有检测到明确指令,不能据此判断是否「偷偷」存储。
- 「一半以上含心理推断」:52% 指心理状态类别,不能当作推断比例;另一项针对全部记忆的来源分析中,14% 为逻辑推断、5% 弱支持、4% 无支持。
- 「28% 含姓名、位置等个人数据」:28% 对,但论文点名的是姓名和身份属性,没有把「位置」列为主要类别。
用户能做什么
论文分析的是早期的「已保存记忆」。当前 ChatGPT 还提供自动更新的记忆摘要,以及回答下方的「来源」入口;用户可以更正或删除相关信息。论文中的比例描述的是当时的样本,不能直接用来衡量新机制。
| 控制项 | 在哪里 | 做了什么 | 没做什么(容易误会的地方) |
|---|---|---|---|
| 关闭记忆(Memory) | 设置 → 个性化 → 记忆 | 不再用记忆来个性化回答 | 不删除过去的聊天;以后重新打开,可能从还在的聊天里生成新记忆 |
| 参考聊天记录(Reference chat history) | 同上(有这一项时) | 关掉后,从过往聊天记住的信息安排在 30 天内删除 | 不删除原聊天,也不删除已保存的记忆 |
| 已保存记忆(Saved memories) | 同上 → 管理;或直接让 ChatGPT 忘记某件事 | 删除后不再用于个性化 | 不删除过去对话里提到它的内容;删聊天也不会自动删掉由它生成的记忆 |
| 记忆摘要(Memory summary) | 同上(有这一项时) | 可以更正;可选「不要再提起」;可选「删除并关闭记忆」 | 「不要再提起」不删除来源;摘要不一定列出全部记住的内容 |
| 回答下方的「来源」 | 有个性化的回答下方 | 看是哪些记忆、聊天、文件起了作用,可以更正或删除 | 不一定显示影响回答的全部因素 |
| 临时聊天 | 新对话选「临时」,发第一条消息前选「非个性化」 | 不创建也不更新记忆;不进聊天记录;临时期间不用于训练模型 | 选「个性化」仍会读取已有记忆;可能保留最多 30 天副本(安全用途);保存后变普通聊天 |
| 改进模型 | 设置 → 数据控制 | 个人账户可关闭「用你的内容改进模型」 | 和记忆是两个开关,要分别设置 |
表:ChatGPT 记忆的几个开关。整理自 OpenAI 帮助中心《Memory in ChatGPT》和《Temporary chat in ChatGPT》,核对于 2026 年 10 月 21 日。功能和设置项因套餐、地区、平台和工作区而不同;删除已保存记忆后,日志最多保留 30 天;关掉记忆或个性化,不会关闭少数高风险场景下的安全用途。
最容易搞错的两点:
- 删聊天不等于删记忆。 记忆和聊天分开存。要移除一条信息,需同时处理记忆和原聊天;若它还在文件或已连接应用中,也要清理相应来源或断开连接。
- 临时聊天要选「非个性化」。 临时聊天不会新建记忆,但选「个性化」时仍会读取已有记忆。
涉及健康、财务、家人的问题,可以用非个性化的临时聊天来问。
做带记忆的 AI 产品:七条原则
1. 分开「用户要记的」和「系统自己记的」。 至少在界面上分开展示,最好分开设开关。
2. 写入时就告诉用户,并允许当场撤销。 比让用户事后去设置里翻好得多。
3. 敏感类别默认不记。 健康、宗教、政治观点、性取向,除非用户明确要求。只靠模型「被训练成不记」挡不干净,写入前要再加一道检查。
4. 多记任务事实,少记对人的判断。 「这个项目用 Swift」帮人干活,「这个用户害怕失败」是在给人下定义。
5. 每条记忆都能查到来源。 点开就能看到它来自哪次对话、哪句话。
6. 删除要说清删到哪一层。 删对话、删记忆、关开关各影响什么,要在界面上讲明白。
7. 给记忆划范围。 按项目或工作区隔离,而不是只有一个全局的「你」。OpenAI 现在也提供只在项目内生效的记忆。
研究的局限
- 样本是 80 位 Prolific 用户,主要在美国和欧洲,不代表全体用户。
- 只研究了「已保存记忆」,没有覆盖「参考聊天记录」。
- 判断用户有没有下指令靠关键词匹配,用别的说法下的指令会被漏掉。